GroupDocs.Parser на перший погляд

Document Parser SDK для високоточного аналізу документів у застосунках Python
Illustration parser

Вилучення даних з документів

GroupDocs.Parser for Python via .NET API дозволяє отримувати текст, метадані, зображення та анотації з широкого спектру форматів файлів, таких як документи Office, електронна пошта, вкладення та архіви. Цей потужний інструмент допомагає ефективно отримувати та обробляти цінну інформацію, що міститься у цих файлах, для різних застосувань, таких як аналіз даних, індексування пошукових систем або системи управління контентом.

Аналіз документів

Вилучайте різні елементи, такі як гіперпосилання, таблиці, QR‑коди, штрих‑коди та дані з PDF‑форм. Також аналізуйте будь‑яку необхідну інформацію з документів за допомогою користувацьких шаблонів.

Налаштування результатів

Python API дозволяє отримувати дані в різних форматах, таких як необроблені, структуровані, HTML або Markdown. Крім того, API пропонує функцію пошуку для знаходження конкретних слів або фраз у тексті документів.

Платформна незалежність

GroupDocs.Parser for Python via .NET підтримує наступні операційні системи, фреймворки та менеджери пакетів

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

Підтримувані формати файлів

GroupDocs.Parser for Python via .NET підтримує роботу з наступними форматами файлів.

Формати Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

Зображення та інші формати

  • Портативний: PDF
  • Зображення: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • Інші офісні формати: ODT, OTT, ODS, OTS, ODP, OTP
  • Текст: TXT, CSV, TSV, XML, MD

Інші формати

  • Веб: HTML, XHTML, MHTML
  • Електронна пошта: EML, EMLX
  • Архіви: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • Електронні книги: EPUB, MOBI, AZW3, FB2, CHM

Функції GroupDocs.Parser for Python via .NET

Швидко та точно витягайте дані з PDF, офісних документів, зображень та інших форматів за допомогою нашого Python Document Parser SDK

Feature icon

Вилучення тексту

Витягайте текстову інформацію з різних форматів файлів, таких як документи Office та PDF, та розпізнавайте текст на сканованих сторінках і зображеннях за допомогою OCR.

Feature icon

Вилучення зображень

Отримуйте візуальний контент з різноманітних джерел, таких як офісні документи, PDF‑файли, для зручного доступу та використання.

Feature icon

Сканування QR‑кодів

Виявляйте та розшифровуйте QR‑коди, що містяться в офісних документах, PDF‑файлах або візуальному контенті, для ефективного отримання інформації.

Feature icon

Вилучення даних з вкладень електронних листів та архівів

Збирайте цінну інформацію з електронних листів, вкладень файлів та стиснених даних для ефективного аналізу та використання.

Feature icon

Вилучення таблиць

Визначайте та витягуйте табличні дані з документів PDF, Word, Excel, PowerPoint та HTML для упорядкованого аналізу та використання.

Feature icon

Вилучення гіперпосилань

Знаходьте та вилучайте гіперпосилання та електронні адреси в офісних документах або PDF‑файлах для зручного доступу.

Feature icon

Розбір PDF‑форм

PDF‑форми — це цифрові документи з заповнюваними полями для взаємодії користувачів, що дозволяє вводити інформацію електронно. API Python можна використовувати для вилучення даних з цих форм для ефективної обробки.

Feature icon

Розбір даних за шаблонами

Створюйте користувацькі шаблони та використовуйте їх разом з API Python для розбору конкретної інформації з PDF‑файлів, спрощуючи процеси вилучення даних.

Feature icon

Пошук тексту в документах

Швидко знаходьте конкретні слова чи шаблони в документах.

Зразки коду

Окрім базового вилучення тексту, ось найпоширеніші випадки використання для швидкого вилучення тексту, зображень та метаданих.

Пошук тексту в документі

Цей приклад демонструє, як шукати певну фразу у PDF‑документі та виводити, де вона була знайдена.

Пошук тексту в документі на Python

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# Завантажте документ
with Parser("sample.pdf") as parser:
    # Шукайте певну фразу в документі
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # Виведіть індекс сторінки та прямокутник, де була знайдена фраза
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

Вилучення зображень з документа

Цей приклад показує, як вилучати зображення з PDF‑документа та зберігати їх у файл.

Вилучення зображень з документа на Python

from groupdocs.parser import Parser

# Завантажте документ
with Parser("sample.pdf") as parser:
    # Вилучіть зображення з документа
    images = parser.get_images() or []

    # Збережіть зображення у файл
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

Вилучення метаданих з документа

Цей приклад демонструє, як вилучити метадані з PDF‑документа та вивести їх.

Вилучення метаданих з документа на Python

from groupdocs.parser import Parser

# Завантажте документ
with Parser("sample.pdf") as parser:
    # Вилучіть метадані з документа
    metadata = parser.get_metadata() or []

    # Виведіть метадані
    for item in metadata:
        print(f"{item.name}: {item.value}")

Готові почати?

Завантажте GroupDocs.Parser безкоштовно або отримайте пробну ліцензію для повного доступу!

Корисні ресурси

Вивчіть документацію, зразки коду та підтримку спільноти для покращення вашого досвіду.

Поради щодо тимчасової ліцензії

1
Зареєструйтеся за допомогою вашої робочої e-mail. Безкоштовні поштові служби заборонені.
2
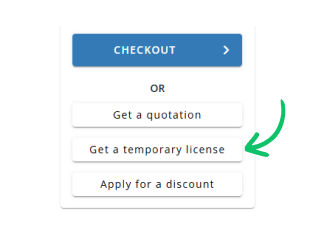
Скористайтеся кнопкою Отримати тимчасову ліцензію на другому кроці.
✕
 Українська