GroupDocs.Parser อย่างคร่าวๆ

Document Parser SDK สำหรับการแยกเอกสารที่ความแม่นยำสูงในแอปพลิเคชัน Python
Illustration parser

สกัดข้อมูลจากเอกสาร

GroupDocs.Parser for Python via .NET API ช่วยให้คุณดึงข้อความ, เมตาดาต้า, รูปภาพและคำอธิบายจากรูปแบบไฟล์หลากหลายเช่น เอกสาร Office, อีเมล, ไฟล์แนบและไฟล์เก็บถาวร. เครื่องมือที่ทรงพลังนี้ช่วยให้คุณเข้าถึงและประมวลผลข้อมูลสำคัญที่อยู่ในไฟล์เหล่านี้ได้อย่างมีประสิทธิภาพสำหรับการใช้งานต่าง ๆ เช่น การวิเคราะห์ข้อมูล, การทำดัชนีเครื่องมือค้นหา, หรือระบบการจัดการเนื้อหา.

แยกเอกสาร

สกัดส่วนประกอบต่าง ๆ เช่น ไฮเปอร์ลิงก์, ตาราง, QR code, barcode และข้อมูลจากแบบฟอร์ม PDF. นอกจากนี้ยังสามารถแยกข้อมูลที่ต้องการใด ๆ จากเอกสารโดยใช้เทมเพลตกำหนดเอง

ปรับแต่งผลลัพธ์

Python API ช่วยให้คุณดึงข้อมูลในรูปแบบต่าง ๆ เช่น raw, structured, HTML หรือ Markdown. นอกจากนี้ API ยังมีฟังก์ชันการค้นหาเพื่อหาคำหรือวลีเฉพาะในข้อความของเอกสาร

ความเป็นอิสระของแพลตฟอร์ม

GroupDocs.Parser for Python via .NET รองรับระบบปฏิบัติการ, เฟรมเวิร์กและตัวจัดการแพคเกจต่อไปนี้

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

รูปแบบไฟล์ที่รองรับ

GroupDocs.Parser for Python via .NET รองรับการทำงานกับ รูปแบบไฟล์ ต่อไปนี้.

รูปแบบ Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

รูปภาพและรูปแบบอื่น ๆ

  • พกพา: PDF
  • รูปภาพ: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • รูปแบบ Office อื่น ๆ: ODT, OTT, ODS, OTS, ODP, OTP
  • ข้อความ: TXT, CSV, TSV, XML, MD

รูปแบบอื่น ๆ

  • เว็บ: HTML, XHTML, MHTML
  • อีเมล: EML, EMLX
  • ไฟล์เก็บข้อมูล: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • อีบุ๊ค: EPUB, MOBI, AZW3, FB2, CHM

คุณลักษณะของ GroupDocs.Parser for Python via .NET

สกัดข้อมูลจาก PDF, เอกสาร Office, รูปภาพและรูปแบบอื่น ๆ อย่างรวดเร็วและแม่นยำด้วย Python Document Parser SDK ของเรา

Feature icon

สกัดข้อความ

สกัดข้อมูลข้อความจากไฟล์ฟอร์แมตต่าง ๆ เช่น เอกสาร Office และไฟล์ PDF, และรับรู้ข้อความในหน้าที่สแกนและรูปภาพด้วย OCR.

Feature icon

สกัดรูปภาพ

ดึงเนื้อหาภาพจากแหล่งต่าง ๆ เช่น เอกสาร Office, ไฟล์ PDF เพื่อการเข้าถึงและใช้งานที่สะดวก

Feature icon

สแกน QR Code

ตรวจหาและถอดรหัส QR code ที่อยู่ในเอกสาร Office, ไฟล์ PDF หรือเนื้อหาภาพเพื่อการรับข้อมูลที่มีประสิทธิภาพ

Feature icon

สกัดข้อมูลจากไฟล์แนบอีเมลและไฟล์บีบอัด

รวบรวมข้อมูลที่มีค่าจากข้อความอีเมล, ไฟล์แนบ และแหล่งข้อมูลที่บีบอัดเพื่อการวิเคราะห์และใช้งานอย่างมีประสิทธิภาพ

Feature icon

สกัดตาราง

ระบุและสกัดข้อมูลตารางจากเอกสาร PDF, Word, Excel, PowerPoint และ HTML เพื่อการวิเคราะห์และใช้งานอย่างเป็นระบบ.

Feature icon

สกัดไฮเปอร์ลิงก์

ค้นหาและดึงลิงก์ไฮเปอร์และที่อยู่อีเมลภายในเอกสาร office หรือไฟล์ PDF เพื่อการเข้าถึงที่มีประสิทธิภาพ

Feature icon

ประมวลผลฟอร์ม PDF

ฟอร์ม PDF คือเอกสารดิจิทัลที่มีช่องกรอกข้อมูลให้ผู้ใช้กรอกข้อมูลได้อย่างอิเล็กทรอนิกส์ API ของ Python สามารถใช้เพื่อดึงข้อมูลจากฟอร์มเหล่านี้เพื่อการประมวลผลที่มีประสิทธิภาพ

Feature icon

ประมวลผลข้อมูลด้วยเทมเพลต

สร้างเทมเพลตที่กำหนดเองและใช้ร่วมกับ API ของ Python เพื่อแยกข้อมูลเฉพาะจากไฟล์ PDF ลดความซับซ้อนของกระบวนการดึงข้อมูล

Feature icon

ค้นหาข้อความในเอกสาร

ค้นหาคำหรือรูปแบบเฉพาะในเอกสารได้อย่างรวดเร็ว

ตัวอย่างโค้ด

นอกเหนือจากการดึงข้อความพื้นฐาน นี่คือกรณีการใช้งานที่พบบ่อยที่สุดสำหรับการดึงข้อความ ภาพ และเมตาดาต้าอย่างรวดเร็ว

ค้นหาข้อความในเอกสาร

ตัวอย่างนี้แสดงวิธีการค้นหาวลีเฉพาะในเอกสาร PDF และพิมพ์ตำแหน่งที่พบ

ค้นหาข้อความในเอกสารด้วย Python

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# โหลดเอกสาร
with Parser("sample.pdf") as parser:
    # ค้นหาวลีเฉพาะในเอกสาร
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # พิมพ์ดัชนีหน้าและสี่เหลี่ยมที่พบวลี
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

ดึงรูปภาพจากเอกสาร

ตัวอย่างนี้แสดงวิธีการดึงรูปภาพจากเอกสาร PDF และบันทึกลงไฟล์

ดึงรูปภาพจากเอกสารด้วย Python

from groupdocs.parser import Parser

# โหลดเอกสาร
with Parser("sample.pdf") as parser:
    # ดึงรูปภาพจากเอกสาร
    images = parser.get_images() or []

    # บันทึกรูปภาพลงไฟล์
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

ดึงเมตาดาต้าจากเอกสาร

ตัวอย่างนี้แสดงวิธีการดึงเมตาดาต้าจากเอกสาร PDF และพิมพ์ออก

ดึงเมตาดาต้าจากเอกสารด้วย Python

from groupdocs.parser import Parser

# โหลดเอกสาร
with Parser("sample.pdf") as parser:
    # ดึงเมตาดาต้าจากเอกสาร
    metadata = parser.get_metadata() or []

    # พิมพ์เมตาดาต้า
    for item in metadata:
        print(f"{item.name}: {item.value}")

พร้อมที่จะเริ่มต้นหรือยัง?

ดาวน์โหลด GroupDocs.Parser ฟรีหรือรับสิทธิ์การใช้งานแบบทดลองใช้เพื่อการเข้าถึงแบบเต็ม!

ทรัพยากรที่มีประโยชน์

สำรวจเอกสารตัวอย่างรหัสและการสนับสนุนชุมชนเพื่อปรับปรุงประสบการณ์ของคุณ

เคล็ดลับใบอนุญาตชั่วคราว

1
ลงทะเบียนด้วยอีเมลที่ทำงานของคุณ ไม่อนุญาตให้ใช้บริการอีเมลฟรี
2
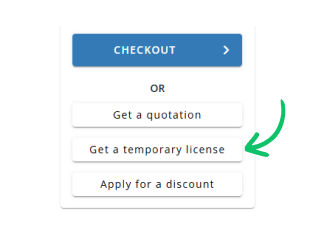
ใช้ปุ่ม รับใบอนุญาตชั่วคราว ในขั้นตอนที่ 2
✕
 ไทย