GroupDocs.Parser в двух словах

Document Parser SDK для выполнения высокоточной обработки документов в приложениях Python
Illustration parser

Извлечение данных из документов

GroupDocs.Parser for Python via .NET API позволяет получать текст, метаданные, изображения и аннотации из широкого спектра форматов файлов, таких как офисные документы, электронные письма, вложения и архивы. Этот мощный инструмент помогает эффективно получать доступ к ценным данным, содержащимся в этих файлах, и обрабатывать их для различных приложений, таких как анализ данных, индексирование поисковых систем или системы управления контентом.

Парсинг документов

Извлекайте различные элементы, такие как гиперссылки, таблицы, QR‑коды, штрихкоды и данные из PDF‑форм. Также парсите любую необходимую информацию из документов с помощью пользовательских шаблонов.

Настройка результатов

Python API позволяет получать данные в различных форматах, таких как необработанные, структурированные, HTML или Markdown. Кроме того, API предоставляет функцию поиска для нахождения конкретных слов или фраз в тексте документов.

Независимость от платформы

GroupDocs.Parser for Python via .NET поддерживает следующие операционные системы, фреймворки и менеджеры пакетов

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

Поддерживаемые форматы файлов

GroupDocs.Parser for Python via .NET поддерживает работу со следующими форматами файлов.

Форматы Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

Изображения и другие форматы

  • Переносимый: PDF
  • Изображения: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • Другие офисные форматы: ODT, OTT, ODS, OTS, ODP, OTP
  • Текст: TXT, CSV, TSV, XML, MD

Другие форматы

  • Веб: HTML, XHTML, MHTML
  • Электронная почта: EML, EMLX
  • Архивы: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • Электронные книги: EPUB, MOBI, AZW3, FB2, CHM

Возможности GroupDocs.Parser for Python via .NET

Извлекайте данные из PDF, офисных документов, изображений и других форматов быстро и точно с помощью нашего Python Document Parser SDK

Feature icon

Извлечение текста

Извлекайте текстовую информацию из различных форматов файлов, таких как офисные документы и PDF-файлы, а также распознавайте текст на отсканированных страницах и изображениях с помощью OCR.

Feature icon

Извлечение изображений

Получайте визуальное содержимое из различных источников, таких как офисные документы и PDF‑файлы, для удобного доступа и использования.

Feature icon

Сканирование QR‑кодов

Обнаруживайте и расшифровывайте QR‑коды, находящиеся в офисных документах, PDF‑файлах или визуальном контенте, для эффективного извлечения информации.

Feature icon

Извлечение данных из вложений электронной почты и архивов

Собирайте ценную информацию из электронных писем, файлов‑вложений и сжатых источников данных для эффективного анализа и использования.

Feature icon

Извлечение таблиц

Определяйте и извлекайте табличные данные из PDF, Word, Excel, PowerPoint и HTML-документов для упорядоченного анализа и использования.

Feature icon

Извлечение гиперссылок

Находите и извлекайте гиперссылки и адреса электронной почты в офисных документах или PDF‑файлах для удобного доступа.

Feature icon

Разбор PDF‑форм

PDF‑формы — это цифровые документы с заполняемыми полями для взаимодействия с пользователем, позволяющие вводить информацию в электронном виде. API Python можно использовать для извлечения данных из этих форм для эффективной обработки.

Feature icon

Разбор данных по шаблонам

Создайте пользовательские шаблоны и используйте их с API Python для разбора конкретной информации из PDF‑файлов, упрощая процессы извлечения данных.

Feature icon

Поиск текста в документах

Быстро находите конкретные слова или шаблоны в документах.

Примеры кода

Помимо базового извлечения текста, ниже представлены типовые сценарии быстрого извлечения текста, изображений и метаданных.

Поиск текста в документе

В этом примере показано, как выполнить поиск конкретной фразы в PDF‑документе и вывести место её нахождения.

Поиск текста в документе на Python

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# Загрузите документ
with Parser("sample.pdf") as parser:
    # Найдите конкретную фразу в документе
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # Выведите номер страницы и прямоугольник, где была найдена фраза
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

Извлечение изображений из документа

В этом примере показано, как извлечь изображения из PDF‑документа и сохранить их в файл.

Извлечение изображений из документа на Python

from groupdocs.parser import Parser

# Загрузите документ
with Parser("sample.pdf") as parser:
    # Извлеките изображения из документа
    images = parser.get_images() or []

    # Сохраните изображения в файл
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

Извлечение метаданных из документа

В этом примере показано, как извлечь метаданные из PDF‑документа и вывести их.

Извлечение метаданных из документа на Python

from groupdocs.parser import Parser

# Загрузите документ
with Parser("sample.pdf") as parser:
    # Извлеките метаданные из документа
    metadata = parser.get_metadata() or []

    # Выведите метаданные
    for item in metadata:
        print(f"{item.name}: {item.value}")

Готовы начать?

Загрузите GroupDocs.Parser бесплатно или получите пробную лицензию для полного доступа!

Полезные ресурсы

Изучите документацию, примеры кода и раздел поддержки, чтобы улучшить ваш опыт.

Советы по временной лицензии

1
Зарегистрируйтесь, используя ваш рабочий e-mail адрес. Бесплатные почтовые сервисы запрещены.
2
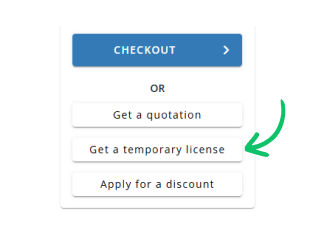
Используйте кнопку Получить временную лицензию на втором шаге.
✕
 Русский