GroupDocs.Parser の概要

Python アプリケーションで高精度な文書解析を実行するための Document Parser SDK
Illustration parser

ドキュメントからデータを抽出

GroupDocs.Parser for Python via .NET API を使用すると、Office ドキュメント、メール、添付ファイル、アーカイブなど、幅広いファイル形式からテキスト、メタデータ、画像、注釈を取得できます。この強力なツールは、データ分析、検索エンジンのインデックス作成、コンテンツ管理システムなどのさまざまなアプリケーションで、これらのファイルに含まれる貴重な情報へ効率的にアクセスし、処理するのに役立ちます。

ドキュメントを解析

PDF フォームからハイパーリンク、テーブル、QR コード、バーコード、およびデータなどのさまざまな要素を抽出します。また、カスタムテンプレートを使用してドキュメントから任意の情報を解析できます。

結果のカスタマイズ

Python API を使用すると、RAW、構造化、HTML、Markdown など、さまざまな形式でデータを取得できます。さらに、ドキュメントテキスト内の特定の単語やフレーズを検索する機能も提供します。

プラットフォームに依存しない

GroupDocs.Parser for Python via .NET は以下のオペレーティングシステム、フレームワーク、パッケージマネージャをサポートします

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

サポートされているファイル形式

GroupDocs.Parser for Python via .NET は以下の ファイル形式 に対応しています。

Microsoft Office 形式

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

画像 & その他の形式

  • ポータブル: PDF
  • 画像: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • その他のオフィス形式: ODT, OTT, ODS, OTS, ODP, OTP
  • テキスト: TXT, CSV, TSV, XML, MD

その他の形式

  • Web: HTML, XHTML, MHTML
  • メール: EML, EMLX
  • アーカイブ: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • 電子書籍: EPUB, MOBI, AZW3, FB2, CHM

GroupDocs.Parser for Python via .NET の機能

当社の Python Document Parser SDK を使用して、PDF、Office ドキュメント、画像、その他の形式からデータを迅速かつ正確に抽出します。

Feature icon

テキストを抽出

Office ドキュメントや PDF ファイルなど、さまざまなファイル形式からテキスト情報を抽出し、スキャンしたページや画像内のテキストを OCR で認識します。

Feature icon

画像を抽出

Office ドキュメントや PDF ファイルなど多様なソースからビジュアルコンテンツを取得し、便利にアクセス・利用できます。

Feature icon

QR コードをスキャン

Office ドキュメント、PDF ファイル、またはビジュアルコンテンツ内にある QR コードを検出し、デコードして情報を効率的に取得します。

Feature icon

メール添付ファイルやアーカイブからデータを抽出

メールメッセージ、ファイル添付、圧縮データソースから有用な情報を収集し、効果的に分析・活用できます。

Feature icon

テーブルを抽出

PDF、Word、Excel、PowerPoint、HTML ドキュメントから表形式データを特定し抽出して、整理された分析や活用に利用できます。

Feature icon

ハイパーリンクを抽出

オフィス文書または PDF ファイル内のハイパーリンクとメールアドレスを検索して抽出し、効率的にアクセスできるようにします。

Feature icon

PDF フォームの解析

PDF フォームは、ユーザーが電子的に情報を入力できる入力可能なフィールドを備えたデジタル文書です。Python API を使用して、これらのフォームからデータを抽出し、効率的に処理できます。

Feature icon

テンプレートによるデータ解析

カスタムテンプレートを作成し、Python API と組み合わせて PDF ファイルから特定の情報を解析し、データ抽出プロセスを簡素化します。

Feature icon

文書内のテキスト検索

文書内の特定の単語やパターンを迅速に検索します。

コードサンプル

基本的なテキスト抽出に加えて、テキスト、画像、メタデータの迅速な抽出に最も一般的なユースケースをご紹介します。

文書内のテキスト検索

この例では、PDF 文書内で特定のフレーズを検索し、見つかった位置を出力する方法を示します。

Python で文書内のテキスト検索

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# 文書をロードする
with Parser("sample.pdf") as parser:
    # 文書内で特定のフレーズを検索する
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # フレーズが見つかったページインデックスと矩形を出力する
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

文書から画像を抽出

この例では、PDF 文書から画像を抽出し、ファイルに保存する方法を示します。

Python で文書から画像を抽出

from groupdocs.parser import Parser

# 文書をロードする
with Parser("sample.pdf") as parser:
    # 文書から画像を抽出する
    images = parser.get_images() or []

    # 画像をファイルに保存する
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

文書からメタデータを抽出

この例では、PDF 文書からメタデータを抽出し、出力する方法を示します。

Python で文書からメタデータを抽出

from groupdocs.parser import Parser

# 文書をロードする
with Parser("sample.pdf") as parser:
    # 文書からメタデータを抽出する
    metadata = parser.get_metadata() or []

    # メタデータを出力する
    for item in metadata:
        print(f"{item.name}: {item.value}")

始める準備はできていますか?

GroupDocs.Parser を無料でダウンロードするか、フルアクセス用の試用版ライセンスを取得してください。

有用なリソース

ドキュメント、コードサンプル、コミュニティサポートを調べて、体験を向上させます。

一時ライセンスのヒント

1
職場の電子メールで登録してください。フリー メール サービスは使用できません。
2
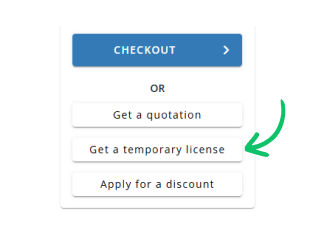
2 番目のステップで [一時ライセンスを取得] ボタンを使用します。
✕
 日本