GroupDocs.Parser sekilas

SDK Document Parser untuk melakukan parsing dokumen dengan akurasi tinggi dalam aplikasi Python
Illustration parser

Ekstrak data dari dokumen

GroupDocs.Parser for Python via .NET API memungkinkan Anda untuk mengambil teks, metadata, gambar, dan anotasi dari berbagai format file seperti dokumen Office, email, lampiran, dan arsip. Alat yang kuat ini membantu Anda mengakses dan memproses informasi berharga yang terdapat dalam file-file tersebut secara efisien untuk berbagai aplikasi seperti analisis data, pengindeksan mesin pencari, atau sistem manajemen konten.

Parse dokumen

Ekstrak berbagai elemen seperti hyperlink, tabel, kode QR, barcode, dan data dari formulir PDF. Juga uraikan informasi apa pun yang diinginkan dari dokumen menggunakan templat khusus.

Menyesuaikan hasil

API Python memungkinkan Anda mengambil data dalam berbagai format seperti mentah, terstruktur, HTML, atau Markdown. Selain itu, API menyediakan fungsi pencarian untuk menemukan kata atau frasa tertentu dalam teks dokumen.

Kemandirian Platform

GroupDocs.Parser for Python via .NET mendukung sistem operasi, kerangka kerja, dan manajer paket berikut

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

Format file yang didukung

GroupDocs.Parser for Python via .NET mendukung operasi dengan format file.

Format Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

Gambar & Format Lain

  • Portable: PDF
  • Gambar: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • Format Office lainnya: ODT, OTT, ODS, OTS, ODP, OTP
  • Teks: TXT, CSV, TSV, XML, MD

Format lain

  • Web: HTML, XHTML, MHTML
  • Surel: EML, EMLX
  • Arsip: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • e-Book: EPUB, MOBI, AZW3, FB2, CHM

Fitur GroupDocs.Parser for Python via .NET

Ekstrak data dari PDF, dokumen Office, gambar, dan format lain dengan cepat dan akurat menggunakan Python Document Parser SDK kami

Feature icon

Ekstrak teks

Ekstrak informasi teks dari berbagai format file seperti dokumen Office dan file PDF, serta kenali teks pada halaman dan gambar yang dipindai dengan OCR.

Feature icon

Ekstrak gambar

Ambil konten visual dari berbagai sumber seperti dokumen office, file PDF untuk akses dan penggunaan yang mudah.

Feature icon

Pindai Kode QR

Deteksi dan dekode kode QR yang terdapat dalam dokumen office, file PDF, atau konten visual untuk pengambilan informasi yang efisien.

Feature icon

Ekstrak data dari lampiran email dan arsip

Kumpulkan informasi berharga dari pesan email, lampiran file, dan sumber data terkompresi untuk analisis dan pemanfaatan yang efektif.

Feature icon

Ekstrak tabel

Identifikasi dan ekstrak data tabel dari dokumen PDF, Word, Excel, PowerPoint, dan HTML untuk analisis dan penggunaan yang terstruktur.

Feature icon

Ekstrak hyperlink

Temukan dan ekstrak tautan hiperteks serta alamat email dalam dokumen office atau file PDF untuk akses yang efisien.

Feature icon

Mengurai Formulir PDF

Python API dapat digunakan untuk mengekstrak data dari formulir ini untuk pemrosesan yang efisien.

Feature icon

Mengurai data dengan templat

Buat templat khusus dan gunakan dengan Python API untuk mengurai informasi spesifik dari file PDF, menyederhanakan proses ekstraksi data.

Feature icon

Cari teks dalam dokumen

Dengan cepat temukan kata atau pola spesifik dalam dokumen.

Contoh kode

Selain ekstraksi teks dasar, berikut adalah contoh penggunaan paling umum untuk ekstraksi cepat teks, gambar, dan metadata.

Cari Teks dalam Dokumen

Contoh ini menunjukkan cara mencari frasa spesifik dalam dokumen PDF dan mencetak lokasi temuan.

Cari Teks dalam Dokumen dengan Python

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# Muat dokumen
with Parser("sample.pdf") as parser:
    # Cari frasa spesifik dalam dokumen
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # Cetak indeks halaman dan persegi panjang tempat frasa ditemukan
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

Ekstrak Gambar dari Dokumen

Contoh ini menunjukkan cara mengekstrak gambar dari dokumen PDF dan menyimpannya ke file.

Ekstrak Gambar dari Dokumen dengan Python

from groupdocs.parser import Parser

# Muat dokumen
with Parser("sample.pdf") as parser:
    # Ekstrak gambar dari dokumen
    images = parser.get_images() or []

    # Simpan gambar ke file
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

Ekstrak Metadata dari Dokumen

Contoh ini menunjukkan cara mengekstrak metadata dari dokumen PDF dan menampilkannya.

Ekstrak Metadata dari Dokumen dengan Python

from groupdocs.parser import Parser

# Muat dokumen
with Parser("sample.pdf") as parser:
    # Ekstrak metadata dari dokumen
    metadata = parser.get_metadata() or []

    # Cetak metadata
    for item in metadata:
        print(f"{item.name}: {item.value}")

Siap untuk memulai?

Unduh GroupDocs.Parser secara gratis atau dapatkan lisensi uji coba untuk akses penuh!

Sumber daya yang berguna

Jelajahi dokumentasi, sampel kode, dan dukungan masyarakat untuk meningkatkan pengalaman Anda.

Tip lisensi sementara

1
Daftar dengan email kantor Anda. Layanan email gratis tidak diperbolehkan.
2
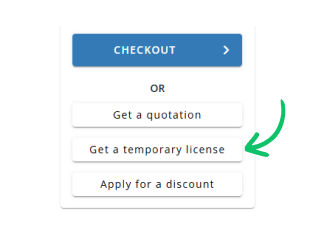
Gunakan tombol Dapatkan lisensi sementara pada langkah kedua.
✕
 Indonesian