GroupDocs.Parser در یک نگاه

SDK تجزیه‌کننده سند برای انجام تجزیه دقیق اسناد در برنامه‌های Python

Illustration parser

استخراج داده‌ها از اسناد

GroupDocs.Parser for Python via .NET API به شما امکان می‌دهد متن، متادیتا، تصاویر و حاشیه‌نویسی‌ها را از مجموعه وسیعی از فرمت‌های فایل مانند اسناد Office، ایمیل‌ها، پیوست‌ها و آرشیوها بازیابی کنید. این ابزار قدرتمند به شما کمک می‌کند تا به‌طور کارآمد به اطلاعات ارزشمند موجود در این فایل‌ها دسترسی یافته و آن را برای برنامه‌های مختلفی مانند تجزیه و تحلیل داده‌ها، ایندکس‌گذاری موتورهای جستجو یا سیستم‌های مدیریت محتوا پردازش کنید.

تجزیه اسناد

عناصر مختلفی مانند هایپرلینک‌ها، جداول، کدهای QR، بارکدها و داده‌ها را از فرم‌های PDF استخراج کنید. همچنین می‌توانید هر اطلاعات دلخواهی را از اسناد با استفاده از قالب‌های سفارشی تجزیه کنید.

سفارشی‌سازی نتایج

Python API به شما امکان می‌دهد داده‌ها را در قالب‌های مختلفی مانند خام، ساختاریافته، HTML یا Markdown بازیابی کنید. علاوه بر این، این API امکان جستجو برای یافتن کلمات یا عبارات خاص در متن اسناد را فراهم می‌کند.

استقلال پلتفرم

GroupDocs.Parser for Python via .NET از سیستم‌عامل‌ها، چارچوب‌ها و مدیرهای بستهٔ زیر پشتیبانی می‌کند

Amazon
Docker
Azure
VS Code
Windows
macOS
Linux
PyPI

قالب‌های فایل پشتیبانی شده

GroupDocs.Parser for Python via .NET عملیات را با فرمت‌های فایل زیر پشتیبانی می‌کند.

فرمت‌های Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLT, XLTX, XLTM, XLAM, XLA
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM
  • Outlook: MSG, PST, OST
  • OneNote: ONE

تصاویر و فرمت‌های دیگر

  • قابل حمل: PDF
  • تصاویر: JPG, JPEG, PNG, BMP, GIF, TIFF, JP2
  • قالب‌های دیگر آفیس: ODT, OTT, ODS, OTS, ODP, OTP
  • متن: TXT, CSV, TSV, XML, MD

فرمت‌های دیگر

  • وب: HTML, XHTML, MHTML
  • ایمیل: EML, EMLX
  • آرشیوها: ZIP, RAR, 7Z, TAR, GZ, BZ2
  • کتاب‌های الکترونیکی: EPUB, MOBI, AZW3, FB2, CHM

امکانات GroupDocs.Parser for Python via .NET

داده‌ها را از PDFها، اسناد Office، تصاویر و سایر قالب‌ها به‌سرعت و با دقت با Python Document Parser SDK ما استخراج کنید.

Feature icon

استخراج متن

اطلاعات متنی را از فرمت‌های مختلف فایل مانند اسناد Office و فایل‌های PDF استخراج کنید و متن را در صفحات و تصاویر اسکن‌شده با استفاده از OCR تشخیص دهید.

Feature icon

استخراج تصاویر

محتوای بصری را از منابع متنوعی مانند اسناد Office و فایل‌های PDF بازیابی کنید تا به‌راحتی دسترسی و استفاده شود.

Feature icon

اسکن کدهای QR

کدهای QR موجود در اسناد Office، فایل‌های PDF یا محتوای بصری را شناسایی و رمزگشایی کنید تا بازیابی اطلاعات به‌صورت کارآمد انجام شود.

Feature icon

استخراج داده‌ها از پیوست‌های ایمیل و آرشیوها

اطلاعات ارزشمند را از پیام‌های ایمیل، پیوست‌های فایل و منابع داده فشرده جمع‌آوری کنید تا تجزیه و تحلیل و استفاده مؤثری داشته باشید.

Feature icon

استخراج جداول

داده‌های جدول‌بندی شده را از اسناد PDF، Word، Excel، PowerPoint و HTML شناسایی و استخراج کنید تا برای تحلیل و استفاده سازمان‌یافته به کار روند.

Feature icon

استخراج هایپرلینک‌ها

در اسناد office یا فایل‌های PDF، پیوندهای ابرمتن و آدرس‌های ایمیل را شناسایی و استخراج کنید تا دسترسی کارآمد شود.

Feature icon

تجزیه فرم‌های PDF

فرم‌های PDF اسناد دیجیتالی هستند که شامل فیلدهای قابل پر شدن برای تعامل کاربر می‌باشند و امکان وارد کردن اطلاعات به صورت الکترونیکی را فراهم می‌کنند. Python API می‌تواند برای استخراج داده‌ها از این فرم‌ها جهت پردازش کارآمد مورد استفاده قرار گیرد.

Feature icon

تجزیه داده‌ها با الگوها

الگوهای سفارشی ایجاد کنید و با استفاده از Python API برای تجزیه اطلاعات خاص از فایل‌های PDF به کار ببرید تا فرآیند استخراج داده‌ها ساده شود.

Feature icon

جستجوی متن در اسناد

به‌سرعت کلمات یا الگوهای خاص را در اسناد پیدا کنید.

نمونه‌های کد

فراتر از استخراج متن پایه، در ادامه رایج‌ترین موارد استفاده برای استخراج سریع متن، تصویر و فراداده آورده شده است.

جستجوی متن در یک سند

این مثال نشان می‌دهد چگونه یک عبارت خاص را در سند PDF جستجو کرده و مکان یافتن آن را چاپ کنید.

جستجوی متن در یک سند با Python

from groupdocs.parser import Parser
from groupdocs.parser.options import PageTextAreaOptions

# سند را بارگذاری کنید
with Parser("sample.pdf") as parser:
    # عبارت خاصی را در سند جستجو کنید
    areas = parser.get_text_areas(PageTextAreaOptions("Total due")) or []

    # اندیس صفحه و مستطیل مکان یافتن عبارت را چاپ کنید
    for area in areas:
        r = area.rectangle
        print(f"Page {area.page.index + 1}: ({r.left:.0f}, {r.top:.0f}) - ({r.right:.0f}, {r.bottom:.0f})")

استخراج تصاویر از یک سند

این مثال نشان می‌دهد چگونه تصاویر را از سند PDF استخراج کرده و در فایلی ذخیره کنید.

استخراج تصاویر از یک سند با Python

from groupdocs.parser import Parser

# سند را بارگذاری کنید
with Parser("sample.pdf") as parser:
    # تصاویر را از سند استخراج کنید
    images = parser.get_images() or []

    # تصاویر را در یک فایل ذخیره کنید
    for index, image in enumerate(images, start=1):
        image.save(f"image_{index}{image.file_type.extension}")

استخراج فراداده از یک سند

این مثال نشان می‌دهد چگونه فراداده را از سند PDF استخراج کرده و چاپ کنید.

استخراج فراداده از یک سند با Python

from groupdocs.parser import Parser

# سند را بارگذاری کنید
with Parser("sample.pdf") as parser:
    # فراداده را از سند استخراج کنید
    metadata = parser.get_metadata() or []

    # فراداده را چاپ کنید
    for item in metadata:
        print(f"{item.name}: {item.value}")

برای شروع آماده اید؟

GroupDocs.Parser را به صورت رایگان دانلود کنید یا یک مجوز آزمایشی برای دسترسی کامل دریافت کنید!

منابع مفید

برای ارتقاء تجربه خود ، مستندات ، نمونه های کد و پشتیبانی جامعه را کاوش کنید.

نکات مجوز موقت

1
با ایمیل کاری خود ثبت نام کنید. خدمات پست الکترونیکی رایگان مجاز نیستند.
2
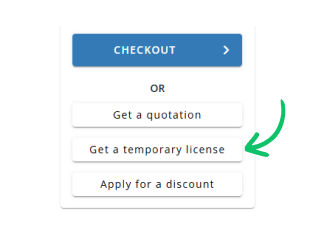
در مرحله دوم از دکمه دریافت مجوز موقت استفاده کنید.
✕
 فارسی